AI 视频动作捕捉又进一步:猫斯卡开源的 ReShot 升级了,参考片一键抽成骨架视频,跳舞武打照着跟,Seedance 和 MiniMax H3 都认,Mac 上 90 秒一条
深度图之外多了骨架和线稿两种参考;为什么骨架不闪是件难事、我们怎么做的;三条演示片用同一套提示词在 MiniMax H3 上重出了一遍,结果如实贴出来
猫斯卡(www.maosika.com)上个月开源的 ReShot,今天发 0.5.0。
参考片不只能抽成深度图了,还能抽成骨架视频和线稿视频。
一段片丢进去,黑底彩色火柴人出来,交给 Seedance 或 MiniMax H3 当参考,动作一根肢体一根肢体地照着来,人换成你的。
还是先验验货。
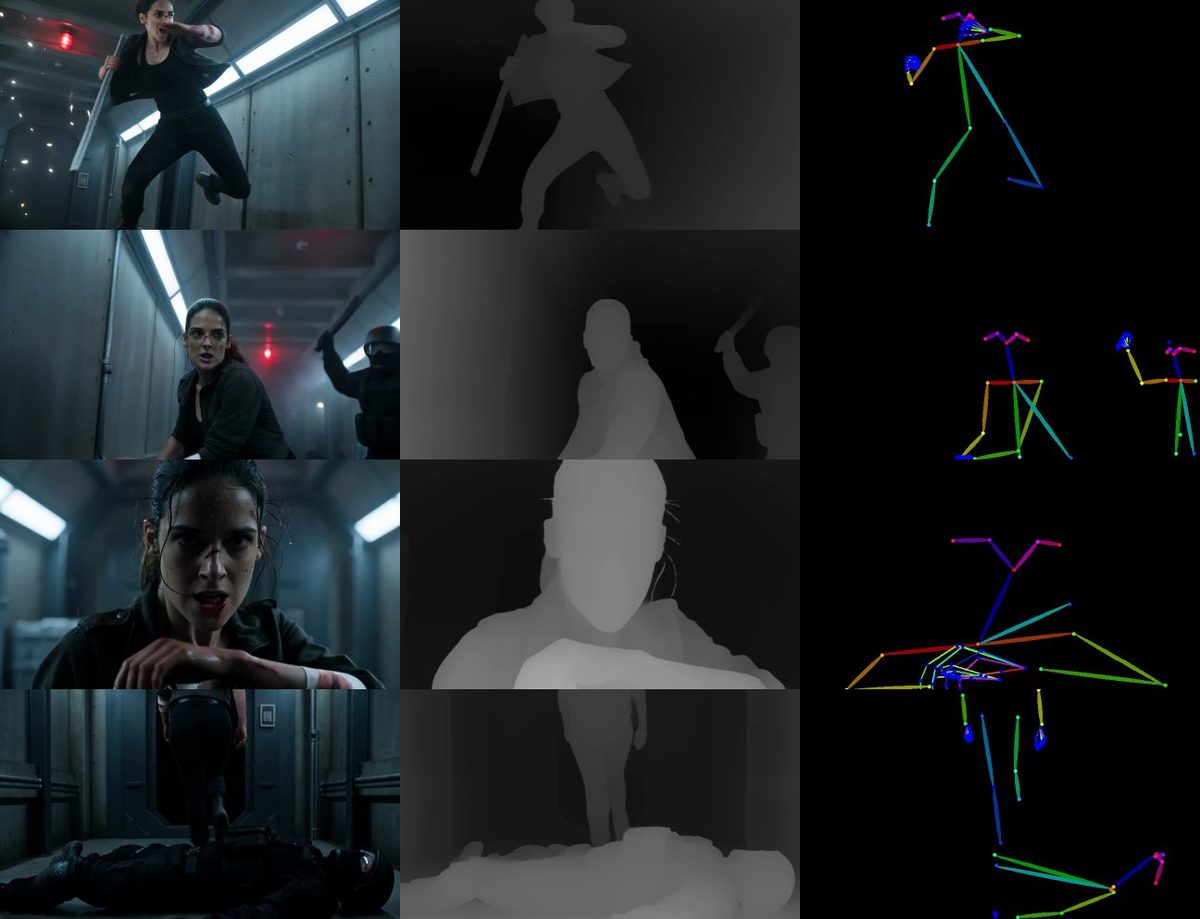
参考片还是那场走廊打戏。
上排右边是 ReShot 抽出来的骨架:每个人一副彩色火柴人,手指头都有,脸没有。
下排三条片,铠甲女战士、旗袍女、卡通兔子拳手,提示词和定妆图跟上次深度图那篇一个字没改,只把挂上去的参考视频从灰片换成了这段骨架。
蹬墙、被抱起来反摔、撞控制台、走出门,六个节拍三条片全在。
摔人那一下,骨架版比深度图版看得更清楚,人是真的被甩到半空的,有点东西。
骨架和深度图各管什么,什么时候选哪个
上次那篇我讲过深度图:把画面压成近白远黑的灰影,只剩「谁站在哪、谁大谁小、怎么动、镜头怎么走」,脸和衣服想抄也没得抄。
骨架是另一条路。
它连灰影都不要,只留关节点和连线。
| 深度图 | 骨架 | |
|---|---|---|
| 带走什么 | 站位、体量、动作、运镜、场景的形状 | 每一根肢体、每一只手,分毫不差 |
| 扔掉什么 | 脸、衣服、光线、画风 | 其余全部,连体型和场景一起扔 |
| 适合 | 什么都行,人和非人 | 跳舞、武打,凡是靠肢体的 |
说人话:跳舞和打戏选骨架,其余选深度图,拿不准就两个都出。
--control depth,pose 一次出两份,喂给模型看它跟哪个跟得好。
为什么跳舞和打戏要选骨架,我说一下我的理由。
深度图里一个人是一团灰影,胳膊贴着身体的时候,影子是连在一起的,模型分不清那只手在身前还是身后。
骨架把这只手单独画出来,连五根手指的朝向都在,跳舞的手势、打戏的抓握,模型一眼看清。
反过来,深度图带着整个房间的形状,人从走廊深处走到镜头前、镜头推进拉远,灰影的大小和明暗都在变,骨架里这些一概没有。
所以走位和运镜为主的戏,深度图更全;肢体细节为主的戏,骨架更准。
线稿是第三种,黑底白线,不用模型,一秒出来。
不过它会把衣服和脸的轮廓也带过去,「只复制走位」对它只成立一半,想要整个画面布局的时候再用。
有一种情况骨架不合适,得先说:大特写。
人只露一张脸,肩和髋都在画面外,估计器照样会猜,把它们画到画面边上,一堆乱线。
特写老老实实用深度图。
骨架不闪,是件难事
抽骨架的模型市面上很多,逐帧跑一遍谁都会。
难的是跑出来能不能用。
逐帧跑有三种闪:两个人隔一帧换个位;关节点每帧抖一两个像素;一根胳膊在阈值附近忽有忽无。
视频模型把这三样全读成动作,生成出来的人就跟着抽。
我们做了三件事。
跨帧给每个人配一个固定身份,用身体框的重叠度来配。
关节一旦画上,要分数掉到远低于阈值才撤,不在阈值边上来回跳。
每个关节各过一个 One-Euro 滤波,静止时稳,出拳时跟得上。
这套和深度图那边「整段只用一把尺子」是同一个道理:决定要在时间轴上做一次,不是每帧各做各的。
模型选的是 DWPose,检人加全身 133 个点,代码和权重都是 Apache-2.0。
选它有个更要紧的原因:ComfyUI 里给 ControlNet 出 pose 图的就是它,画法也是 OpenPose 那套,所以我们出的骨架和视频模型训练时见过的长得一样。
默认画手、不画脸。
手是抓握和手势,得留;脸型正是咱要扔掉的东西。
速度
检人是大头。
Mac 的 CPU 上检人一帧 368 毫秒,估点只要 75 毫秒。
所以检人每三帧跑一次,中间两帧用上一帧的骨架推出人框;片子里出现剪切、或者哪个骨架分数掉到不可信,检人立刻回来。
289 帧的走廊片,这样跑和逐帧检人比:280 帧人数完全一样,八成关节误差在 2 个像素以内,快 35%。
差的那 9 帧是有人进画面时骨架晚了一两帧出现,不放心可以关掉,--pose-detect-every 1。
M2 Max 的 Mac 上,12 秒的片 90 秒出骨架,N 卡装 onnxruntime-gpu 会更快。
怎么用
装:
pip install "reshot[pose]"
reshot
浏览器弹出页面,右上多了「出什么」三选一:深度图、骨架、线稿。
选骨架,把片子丢进去,点一下。
参考片和骨架并排预览,下载按钮旁边多一个「下载关键点 JSON」——每帧每个人 134 个点带分数,每个人一个固定编号,想改、想重定向到别的骨架、想做分析都能拿去用。
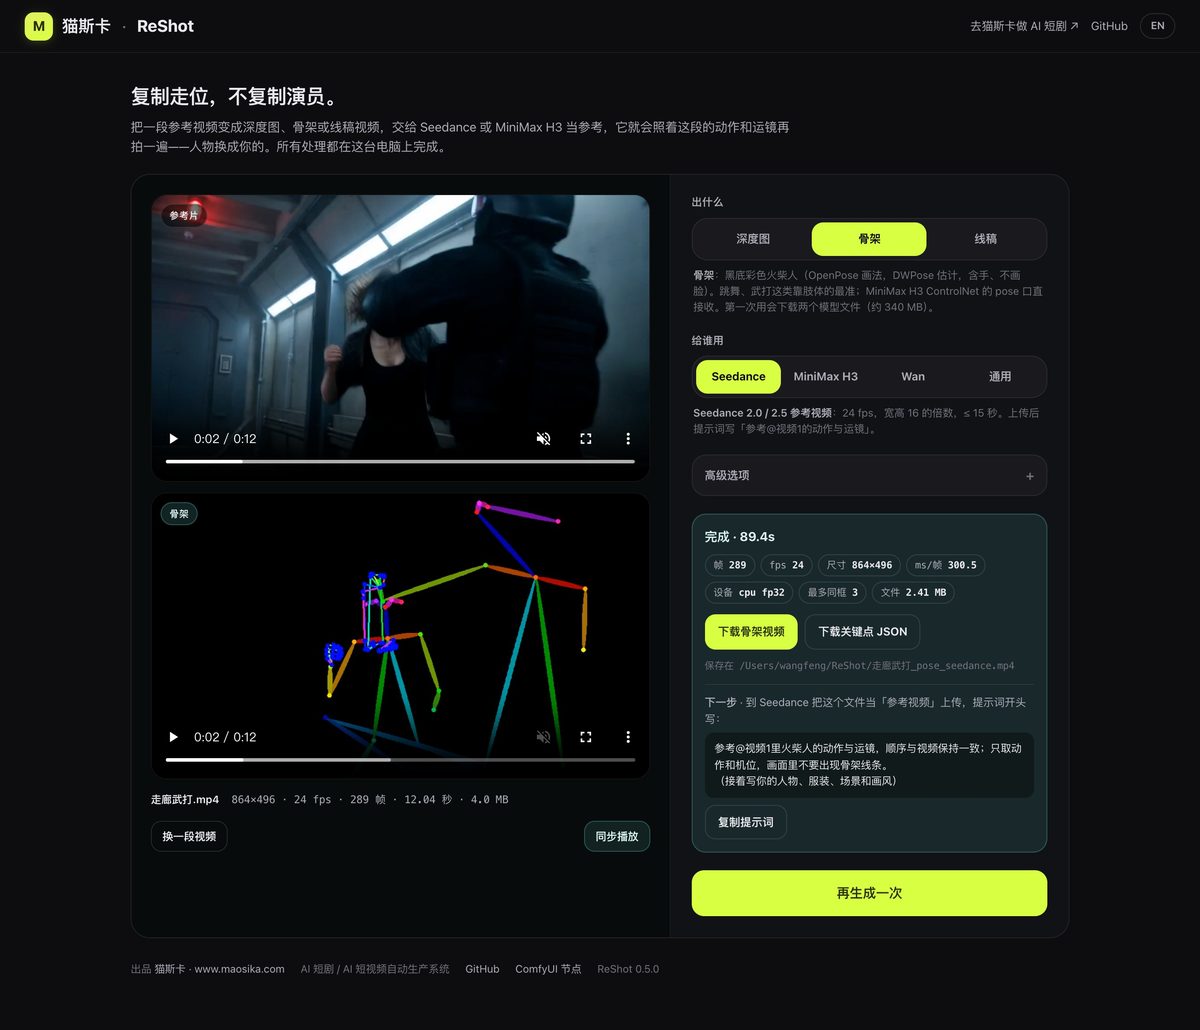
命令行:reshot 参考片.mp4 -o 骨架.mp4 --control pose --target h3。
ComfyUI:节点包 ComfyUI-ReShot 升到 0.2.0,加了 Pose 和 Canny 各两个节点,跟原来的 Depth 一样,一个吃视频吐视频,一个吃帧吐帧,MiniMax H3 Fun ControlNet 的 pose 口直接接。
第一次用会下载两个模型文件,约 340 MB,中国大陆先设一下镜像 export HF_ENDPOINT=https://hf-mirror.com。
真机验证,如实说
上面三条片是在 MiniMax H3 上出的,提示词、定妆图、参考片尺寸都和深度图那次一样,只改了描述参考片的两句话:「这是一段灰色深度图」改成「这是一段 OpenPose 骨架视频」,「灰色外观不要抄」改成「火柴人的样子不要抄」。
三条的完整提示词和 seed 都在仓库 docs/prompts/ 里,大伙儿可以自己去对。
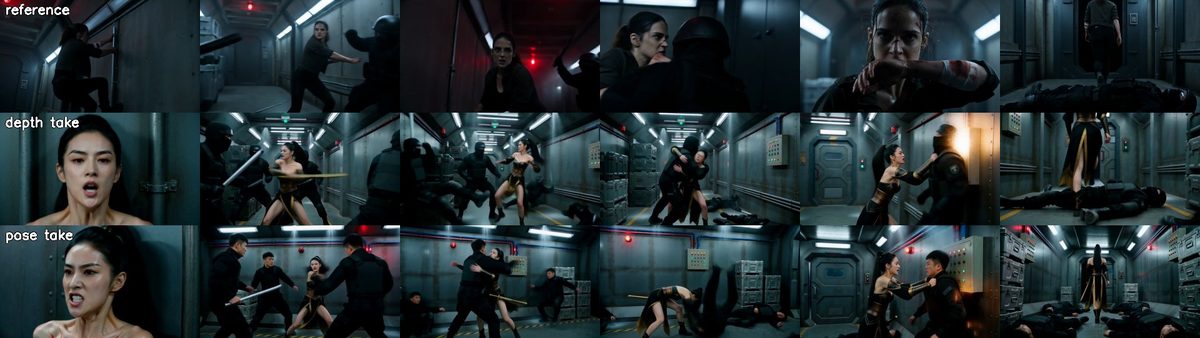
六个节拍都复现了,和深度图版一个水平。
每种条件我只出了一条,seed 也不同,所以只能说「骨架当参考视频也行」,不能说「骨架更好」。
挑一根刺:参考片第二镜是蹬墙扯管子,两种参考都直接进了群殴,虽然后面五镜全对上了,这一镜谁都没做到。
这是模型对那一镜的理解问题,不是参考片的锅。。。
GitHub 搜 maosika-ai/reshot,或者 pip install "reshot[pose]"。
用骨架做了跳舞的片,去仓库的 Discussions 贴一条,打戏我测够了,舞蹈还想看。
猫斯卡(www.maosika.com)站内锁的是「谁」,ReShot 锁的是「怎么动」,两样凑齐,一场戏剩下交给模型的只有光线和画风。
链接
- 代码仓库:github.com/maosika-ai/reshot(Apache-2.0,中英文说明各一份)
- 这次的更新说明:releases/tag/v0.5.0
- ComfyUI 节点:github.com/maosika-ai/ComfyUI-ReShot
- PyPI:pypi.org/project/reshot
- 上一篇(深度图):www.maosika.com/p/1024
- 猫斯卡官网:www.maosika.com
关于猫斯卡 | 猫斯卡 · 专业AI视频自动生产系统。把创意评估、剧本写作、人物场景道具定妆、镜头提示词与出片串成一条可审、可改、可回退的生产链。官网:www.maosika.com